

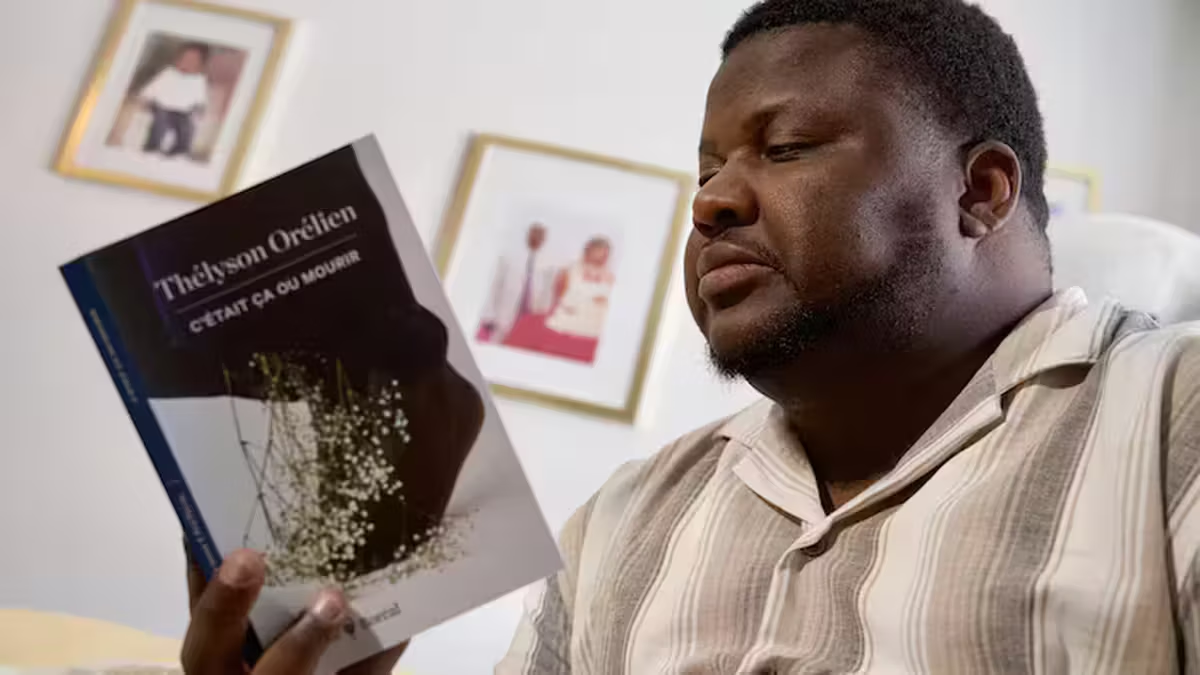
C’est l’accusation qui vient perturber le parcours spectaculaire de l’un des romans phénomènes de la rentrée. Au lendemain du Prix du Roman Fnac décerné à Thélyson Orélien, un compte anonyme affirme que de nombreux passages de « C’était ça ou mourir » seraient détectés comme générés par intelligence artificielle. Nous avons remonté l’origine de cette accusation, examiné les performances du logiciel utilisé et reconstitué le parcours d’écriture du livre. À ce stade, aucun élément disponible ne permet d’établir que le roman a été « presque intégralement » écrit par une IA.
L’affaire démarre le 21 septembre sur X. Un compte baptisé « Balance ton Claude », dont l’identifiant est @Pangramed, publie plusieurs captures présentées comme les résultats d’analyses réalisées avec Pangram, l’un des détecteurs de textes générés par intelligence artificielle les plus réputés du marché. Selon ce compte, différents passages de C’était ça ou mourir, dont les deux premiers chapitres, auraient été classés comme générés par IA. L’auteur du message va beaucoup plus loin : il affirme que le roman aurait été rédigé « presque intégralement » par une intelligence artificielle et s’interroge sur l’absence d’un « co-auteur » crédité. Un point doit cependant être posé immédiatement : le compte @Pangramed est anonyme et rien dans les informations publiques que nous avons pu vérifier ne permet de l’identifier comme un compte officiel de la société Pangram Labs, qui développe le logiciel utilisé.
L’accusation intervient au pire moment pour l’écrivain québécois d’origine haïtienne. Publié en mars au Québec chez Boréal puis le 19 août chez Grasset en France, C’était ça ou mourir s’est imposé en quelques semaines parmi les succès de la rentrée. Le roman a remporté les prix Méduse, Première Plume et Strasbourg avant de recevoir, le 21 septembre, le Prix du Roman Fnac 2026. Selon Livres Hebdo, près de 35 000 exemplaires avaient déjà été écoulés en France et le livre figure dans les sélections de plusieurs grands prix d’automne, dont le Goncourt, le Renaudot, le Femina et le Médicis. L’ampleur de cette réussite explique en partie la vitesse avec laquelle les captures du détecteur ont circulé. Elle ne transforme cependant pas un résultat algorithmique en preuve d’une fraude littéraire.
Ce que le détecteur Pangram permet réellement d’affirmer
Pangram n’est pas un gadget. La société a développé un système nettement plus performant que les premières générations de détecteurs fondés principalement sur la « perplexité » des textes. Pangram affirme que sa dernière version atteint un taux global de faux positifs de 0,0041 % sur un million de textes humains en anglais et publie également des mesures très faibles sur les livres et l’écriture créative. Des travaux indépendants relayés cet été par Nature ont eux aussi constaté de très bonnes performances : sur un jeu de 495 textes humains, Pangram n’avait produit aucun faux positif. Mais même Pangram reconnaît explicitement que son système conserve un taux d’erreur non nul et que de fausses accusations peuvent entraîner des conséquences graves. Un détecteur fournit donc un indice, parfois solide, pas une expertise permettant à lui seul d’établir l’identité réelle de l’auteur d’un texte. Nature
Un autre problème concerne le calcul avancé dans le message viral. Son auteur prend le taux de faux positifs de 0,0041 % et l’élève à la puissance vingt pour soutenir que la probabilité de vingt erreurs successives serait pratiquement nulle. Ce raisonnement ne fonctionne que si les vingt tests sont statistiquement indépendants. Or des passages prélevés dans un même roman, écrit dans un même style, ne constituent pas vingt expériences indépendantes : si certaines caractéristiques stylistiques d’un auteur conduisent le détecteur à se tromper une première fois, les mêmes caractéristiques peuvent se retrouver cent pages plus loin. L’histoire récente incite d’ailleurs à la prudence. En mai, Pangram avait signalé plusieurs textes primés au Commonwealth Short Story Prize comme probablement générés par IA. La Commonwealth Foundation a alors mené un mois d’enquête, examiné les brouillons, documents horodatés et notes des écrivains concernés, avant de conclure que l’IA n’avait pas servi à écrire les nouvelles lauréates. Elle a maintenu les prix en estimant qu’un détecteur ne pouvait constituer une preuve suffisante à lui seul.
Des traces d’écriture qui précèdent largement ChatGPT
Le parcours de Thélyson Orélien constitue par ailleurs un élément impossible à ignorer. Contrairement à l’image d’un auteur apparu soudainement avec ce premier roman, il écrit depuis près de vingt ans. En 2007, à 19 ans, il remportait en Suisse un prix de jeunes auteurs avec Les Couleurs de ma terre, ensuite publié par les Éditions de l’Hèbe. Un texte de cette période est toujours consultable sur son ancien site et témoigne déjà d’une écriture très imagée, rythmée, mêlant poésie et prose, bien avant l’apparition des grands modèles génératifs actuels. Il publie ensuite de la poésie, participe à des revues et anthologies et fait paraître Le temps qui reste en 2015. Interrogé cet été par Le Point, il expliquait avoir emporté avec lui des manuscrits inachevés lorsqu’il avait quitté Haïti et avoir « jamais cessé d’écrire ». Cette antériorité ne démontre évidemment pas qu’aucun outil d’IA n’a pu être utilisé en 2026, mais elle rend beaucoup plus fragile l’idée selon laquelle la voix littéraire repérée dans le roman serait apparue ex nihilo avec ChatGPT.
Surtout, la genèse de C’était ça ou mourir est documentée depuis plusieurs mois, avant la polémique. Orélien situe les prémices du projet autour de 2017, lorsqu’il travaillait comme journaliste et rencontrait des migrants arrivés au Canada. Il affirme avoir recueilli de nombreux témoignages puis voyagé dans plusieurs régions des États-Unis et jusqu’au Mexique pour documenter les différentes étapes de l’exil. Le Temps rapporte qu’il a consacré deux années à ces déplacements, entre zones de transit, aéroports et centres accueillant des réfugiés ; le Journal de Montréal avait déjà détaillé dès avril ses rencontres à Mexico, Buffalo, au Texas, en Floride ou à New York. Ces éléments ne permettent toujours pas de certifier ce qui s’est passé devant son ordinateur lors de chaque phase de rédaction. Pour trancher sérieusement la question, il faudrait examiner les différentes versions du manuscrit, leurs dates de création, les échanges éditoriaux avec Boréal, éventuellement l’historique de révision des fichiers et obtenir les explications de l’auteur et de ses éditeurs. Au moment de nos recherches ce 22 septembre, ni Grasset ni Boréal n’avaient publié sur leurs espaces officiels de réponse détaillée à l’accusation, et nous n’avons trouvé aucune déclaration publique de Thélyson Orélien répondant directement aux tests Pangram. En l’état des éléments accessibles, parler d’un roman « presque intégralement écrit par une IA » dépasse donc ce que les preuves disponibles permettent d’affirmer.


Communauté
Commentaires
Écrire un commentaire
Soyez le premier à commenter cet article.